3.02 · Operaciones con Arreglos y Complejidad Algorítmica
🧠 Teoría y conceptos — 🔁 1. Recorrido: el pan de cada día
Ya lo viste en 3.1, pero aquí lo usamos como herramienta base:
int notas[] = {85, 92, 78, 95, 88};int n = 5;
for (int i = 0; i < n; i++) {
cout << "notas[" << i << "] = " << notas[i] << endl;
}
Regla: el 90% de las operaciones sobre arreglos son un for con algo dentro. Memoriza esta estructura.
➕ 2. Suma y promedio
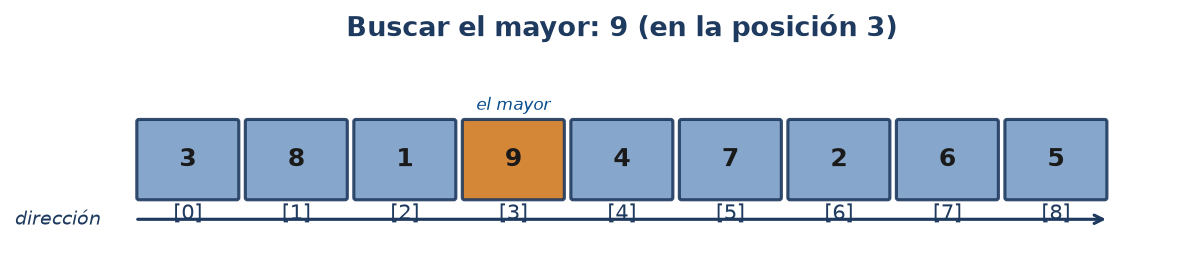
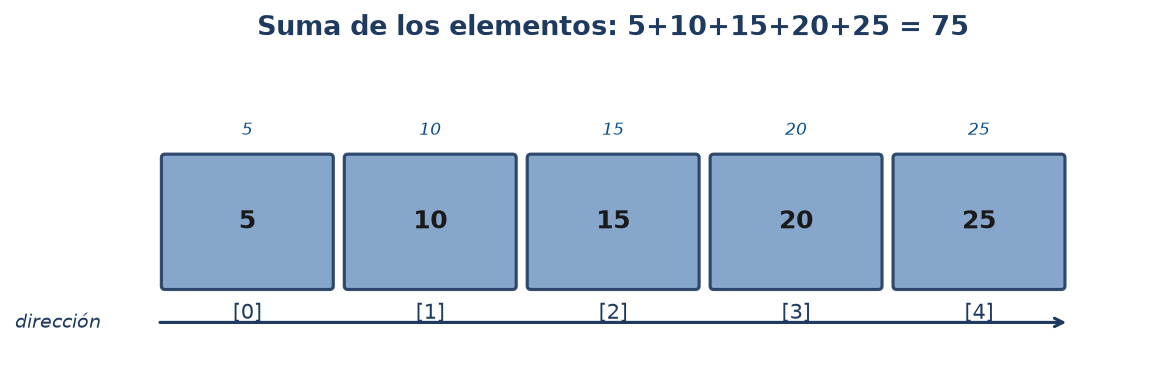
Figura: Suma acumulada de un arreglo
Algoritmo (en tu cabeza, no en código):- Empiezo con suma = 0.
- Por cada elemento, lo agrego a suma.
- Al final, promedio = suma / n.
int notas[] = {85, 92, 78, 95, 88};int n = 5;
int suma = 0;
for (int i = 0; i < n; i++) {suma = suma + notas[i];
// o más corto: suma += notas[i];
}
double promedio = (double)suma / n;
cout << "Suma: " << suma << endl;
cout << "Promedio: " << promedio << endl;
Salida:
Suma: 438
Promedio: 87.6
⚠️ Trampa común: división entera
double promedio = suma / n; // MAL: 87 (truncado)
double promedio = (double)suma / n; // BIEN: 87.6
Si ambos operandos son int, el resultado es int. El cast `(double)` antes de la división es obligatorio.🏆 3. Encontrar el mayor (y el menor)
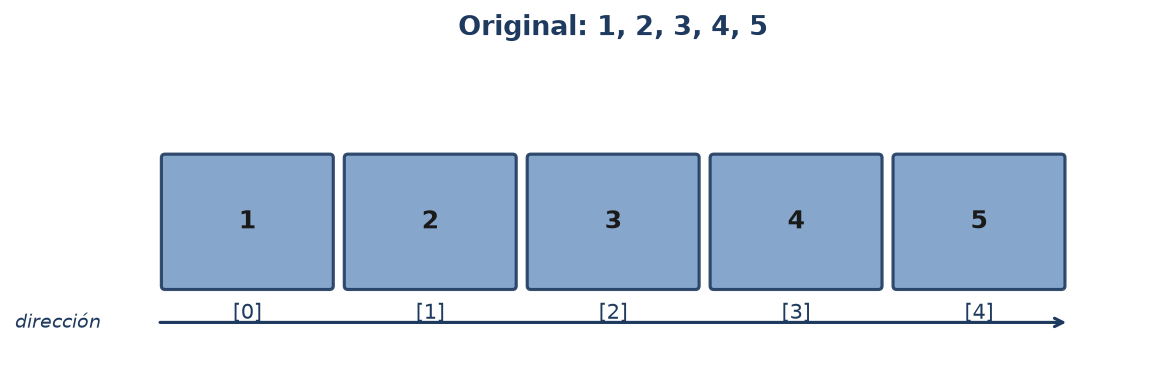
Figura: Búsqueda del mayor elemento
Algoritmo mental:- Asumo que el primero es el mayor (mayor = arr[0]).
- Recorro desde el segundo. Si encuentro uno más grande → ese es el nuevo mayor.
- Al terminar, mayor tiene el valor máximo.
int notas[] = {85, 92, 78, 95, 88};int n = 5;
int mayor = notas[0]; // primer elemento como referencia
for (int i = 1; i < n; i++) {  // empiezo desde 1
if (notas[i] > mayor) {
mayor = notas[i];
}
}
cout << "Mayor: " << mayor << endl; // 95¿Por qué empezar desde 1? Si empiezas desde 0, comparas el primer elemento consigo mismo (siempre se cumple) — funciona, pero es un paso inútil. Optimizar empieza por no hacer trabajo innecesario.
Versión con índice y valor a la vez
int mayor = notas[0];
int posMayor = 0;
for (int i = 1; i < n; i++) {
if (notas[i] > mayor) {
mayor = notas[i];
posMayor = i;
}
}
cout << "Mayor: " << mayor << " en posicion " << posMayor << endl;Devolver el valor es útil. Devolver la posición es a veces más útil (para editar, eliminar, etc.).
🔄 4. Inversión in-place
Concepto: voltear el arreglo de izquierda a derecha, sin usar otro arreglo.
Figura: Inversión de un arreglo - estado original
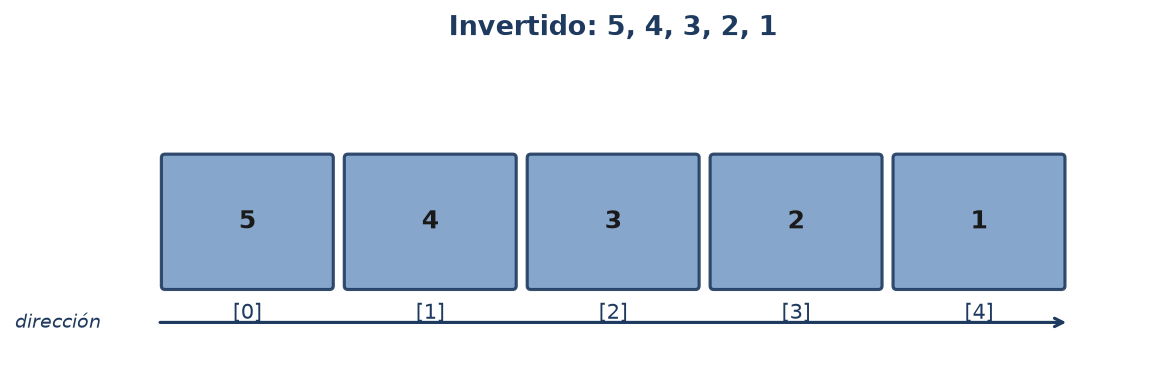
Estrategia: dos índices — uno al inicio, otro al final — que caminan hacia el centro, intercambiando.
Figura: Inversión de un arreglo - estado final
int arr[] = {1, 2, 3, 4, 5};int n = 5;
int izq = 0; // primer índice
int der = n - 1; // último índice
while (izq < der) {// intercambiar arr[izq] y arr[der]
int temp = arr[izq];
arr[izq] = arr[der];
arr[der] = temp;
izq++;
der--;
}
// Resultado: {5, 4, 3, 2, 1}Traza mental paso a paso
Resultado: {5, 4, 3, 2, 1}. Solo 2 intercambios (no 5) porque cada uno arregla dos posiciones.⚠️ ¿Por qué la variable temp?
a = b; // ahora a y b valen lo mismo (perdiste el original de a)
b = a; // no sirve de nada
Para no perder el valor, lo guardas en temp antes de sobrescribir. Es la danza de las tres sillas.🔍 5. Búsqueda de duplicados
Problema: ¿hay algún número que aparezca dos veces en el arreglo?
Algoritmo (fuerza bruta, O(n²)): Para cada posición, comparo con todas las siguientes. Si alguna coincide → hay duplicado.int arr[] = {3, 7, 2, 7, 5};int n = 5;
bool hayDuplicado = false;
for (int i = 0; i < n - 1; i++) {
for (int j = i + 1; j < n; j++) {
if (arr[i] == arr[j]) {
cout << "Duplicado: " << arr[i]
<< " en posiciones " << i << " y " << j << endl;
hayDuplicado = true;
}
}
}
if (!hayDuplicado) cout << "Sin duplicados" << endl;Salida: Duplicado: 7 en posiciones 1 y 3.
Esto funciona, pero más adelante verás que tiene un costo alto.
📊 6. Conteo de frecuencia
Problema: contar cuántas veces aparece cada valor.
int notas[] = {85, 92, 85, 78, 92, 85};int n = 6;
// Como las notas están entre 0 y 100, uso un arreglo de 101 contadores
int frecuencia[101] = {0};  // todo en ceros
for (int i = 0; i < n; i++) {
int nota = notas[i];
frecuencia[nota]++;
}
cout << "85 aparece " << frecuencia[85] << " veces" << endl;  // 3
cout << "92 aparece " << frecuencia[92] << " veces" << endl;  // 2
cout << "78 aparece " << frecuencia[78] << " veces" << endl;  // 1
Concepto clave: un arreglo de contadores es un patrón que usarás toda tu vida (histogramas, votos, edades, ASCII, etc.).
⏱️ 7. Complejidad algorítmica: la pregunta importante
Hasta ahora medimos operaciones en cantidad de pasos. Comparemos dos versiones del mismo problema:
Versión 1: buscar si un valor existe (recorriendo una vez)
bool existe(int arr[], int n, int objetivo) {
for (int i = 0; i < n; i++) {
if (arr[i] == objetivo) return true;
}
return false;}
Pasos en el peor caso: n (recorres todo sin encontrarlo).
Versión 2: contar cuántas veces aparece (doble recorrido)
int contar(int arr[], int n, int objetivo) {
int contador = 0;
for (int i = 0; i < n; i++) {       // n pasos
for (int j = 0; j < n; j++) {   // por cada i, n pasos más
if (arr[i] == arr[j]) contador++;
}
}
return contador / 2; // cada par se cuenta dos veces}
Pasos: n × n = n². Con n = 10 000 son 100 000 000 de comparaciones.
La notación Big O
Reglas de oro:
- Un solo `for` que recorre el arreglo → O(n).
- Un `for` dentro de otro `for` → O(n²).
- Operaciones aritméticas o de acceso directo → O(1).
- Dividir el problema a la mitad cada vez → O(log n). (Lo verás en búsqueda binaria, Tema 3.5.)
¿Cuándo importa en la práctica?
A n = 1 000 000 ya no hablamos de "un poquito más lento" sino de inutilizable.
🧪 8. Medición empírica con
En C++ puedes medir el tiempo real de tu código:
#include <iostream>
#include <chrono>
using namespace std;
int main() {
// Crear arreglo grande
const int N = 100000;
int arr[N];
for (int i = 0; i < N; i++) arr[i] = i;// Medir búsqueda lineal
auto inicio = chrono::high_resolution_clock::now();
long long suma = 0;
for (int i = 0; i < N; i++) suma += arr[i];auto fin = chrono::high_resolution_clock::now();
auto duracion = chrono::duration_cast<chrono::microseconds>(fin - inicio);
cout << "Suma: " << suma << endl;
cout << "Tiempo: " << duracion.count() << " microsegundos" << endl;
return 0;
}
Salida típica: Tiempo: 250 microsegundos.
Regla: si vas a comparar algoritmos, mide. La intuición sobre "este es más rápido" muchas veces se equivoca.
🧪 11. LAB 3.2 — Sistema de Estadísticas de Ventas (4 h)
Descripción
Una tienda tiene las ventas de 30 días en un arreglo. Construye un programa que:
- Calcule el total y el promedio diario.
- Encuentre el día de mayor venta y el día de menor venta.
- Cuente cuántos días superaron el promedio.
- Invierta el arreglo (mostrar la serie original y la invertida).
- Imprima un histograma simple en consola (asteriscos por cada día).
Datos de prueba
int ventas[30] = {120, 85, 200, 150, 95, 220, 175, // semana 1
130, 110, 180, 240, 195, 90, 160, // semana 2
210, 145, 100, 230, 170, 125, 205, // semana 3
140, 155, 190, 115, 250, 135, 165, // semana 4
185, 100};Rúbrica de evaluación
Bonus XP
- +50 XP si la función de mayor/menor retorna ambas cosas (valor y posición) usando struct.
- +30 XP si mides el tiempo de las funciones con <chrono> y lo imprimes.
- +20 XP si ordenas el arreglo con sort() y vuelves a medir el tiempo (comparación empírica O(n log n) vs O(n²) del burbuja).
🔚 13. Cierre — Cuaderno del programador
Escribe en tu cuaderno, con tus palabras:
- ¿Qué operación me costó más entender? (suma, mayor, inversión, conteo)
- Dibuja un arreglo de 6 elementos y simula el algoritmo del mayor paso a paso. Verifica con un compañero.
- Piensa en un problema real (ventas de tu familia, calificaciones del semestre) donde un algoritmo O(n²) sería aceptable y uno donde NO lo sería.
- Reflexión: ¿cuándo fue la última vez que mediste el tiempo de un programa? ¿Por qué no lo haces siempre?
🏅 Insignia y XP del tema
Has desbloqueado la insignia 🧮. Compártela en tu grupo si quieres, o no. Lo importante es lo que ahora puedes hacer con un arreglo: procesarlo, medirlo y elegir el algoritmo correcto.
🔗 ¿Qué sigue?
Tema 3.3 — Cadenas de caracteres y Expresiones Regulares. Las strings en C++ son arreglos de char con superpoderes: concatenación, búsqueda, reemplazo. Verás por qué std::string te salva la vida y cómo validar un email o un teléfono con regex.
Antes de avanzar, asegúrate de:
- [ ] Completar el LAB 3.2.
- [ ] Responder el Quest mixto.
- [ ] Escribir la reflexión en el cuaderno.
*"Un programa que funciona es bueno. Un programa que funciona y es eficiente es ingeniería."*
⚠️ Errores típicos — ⚠️ 10. Errores típicos del razonamiento (no del código)
Error 1: Creer que "más código = más eficiente"
// 5 líneas con dos for anidados
for (int i = 0; i < n; i++)
for (int j = 0; j < n; j++)
if (arr[i] == arr[j]) ...
// vs 3 líneas con un solo for
for (int i = 0; i < n; i++) contador += (arr[i] == x);Menos código no siempre es más rápido, pero dos loops anidados casi siempre son O(n²), y eso cuesta.
Error 2: Empezar el mayor desde i = 0
int mayor = 0; // MAL si todos los números son negativos
for (int i = 0; i < n; i++) {
if (arr[i] > mayor) mayor = arr[i];
}
Si los datos son siempre positivos funciona "por accidente". El patrón correcto es mayor = arr[0].Error 3: Olvidar el < en el while de inversión
while (izq <= der) { // MAL: cuando n es impar, intercambia el central consigo mismo// swap
izq++; der--;}
Con n = 5, el central (índice 2) se intercambia consigo mismo. No rompe, pero es un paso inútil. Usa izq < der.
Error 4: Confundir "no encontré" con "no existe"
Si tu función retorna -1 para "no encontrado", siempre revisa el retorno antes de usar el valor. Saltarse esa revisión es el bug más común de este tema.Error 5: Comparar longitudes de strings como si fueran int
char nombre[] = "Ana";
int largo = sizeof(nombre) / sizeof(nombre[0]); // 4 (incluye el '\0')
int largoReal = strlen(nombre); // 3
sizeof te da el tamaño del arreglo, strlen te da la longitud de la cadena. No son lo mismo.
🤖 IA como copiloto — 🤖 9. AI Mission — "Explica sin código"
Objetivo: Entrenar la explicación de conceptos sin usar sintaxis.
Prompt sugerido (a ChatGPT/Claude/Gemini):
"Soy estudiante. Explícame con una analogía de la vida real la diferencia entre un algoritmo O(n) y un algoritmo O(n²). No uses código ni fórmulas matemáticas."
Lo que NO debes hacer:
- Pedirle que te genere la solución del LAB.
- Pedirle que traduzca pseudocódigo a C++ sin que tú ya lo entiendas.
Lo que SÍ debes hacer:
- Verificar la analogía con tu propia experiencia (¿realmente aplica?).
- Reescribir la analogía con tus palabras en el cuaderno.
Ritual de 3 minutos: si la IA no te lo explica bien en 3 min → para, relee tu cuaderno, reformula la pregunta.
📝 Quest · Cuestionario — 📝 Quest — Reactivos para autoevaluación
Las siguientes preguntas te sirven para autoevaluarte después de leer el tema. Responde en tu cuaderno o mentalmente, y luego revisa las Respuestas modelo (disponibles en libre acceso, sin iniciar sesión).
Sección A · Opción múltiple
Elige la opción correcta (A, B, C o D). Las respuestas están en la sección Respuestas modelo.
- ¿Qué es la complejidad algorítmica?
- La cantidad de código
- Medida de los recursos (tiempo, memoria) según el tamaño de entrada
- El número de líneas
- El número de variables
- ¿Qué significa O(n)?
- Constante
- Lineal: tiempo proporcional al tamaño
- Cuadrático
- Logarítmico
- ¿Qué significa O(1)?
- Una operación
- Constante: tiempo fijo independiente de n
- Logarítmico
- Lineal
- O(n²) es típico de:
- Búsqueda binaria
- Bucles anidados sobre la misma entrada
- Acceso a array
- Hashing
- O(log n) es típico de:
- Búsqueda lineal
- Búsqueda binaria
- Burbuja
- Sumar elementos
- O(n log n) es típico de:
- Búsqueda lineal
- Mergesort, heapsort
- Burbuja
- Acceso directo
- ¿Qué es la búsqueda lineal?
- Busca en una línea de texto
- Recorre el arreglo elemento por elemento
- Divide y vencerás
- Hash
- ¿Cuál es más rápido: O(1) o O(log n)?
- O(log n)
- O(1)
- Iguales
- Depende
- Big-O describe el:
- Mejor caso
- Peor caso o cota superior asintótica
- Caso promedio solamente
- Tiempo exacto
- ¿Qué es la notación Ω (Omega)?
- Peor caso
- Cota inferior (mejor caso)
- Promedio
- Constante
Sección B · Preguntas abiertas
Desarrolla tu respuesta en al menos 3 líneas. Compara con la respuesta modelo después de escribir.
- Compara O(n), O(n log n) y O(n²) para n=10,000. ¿Cuál elegirías?→ Escribe tu respuesta aquí (en tu cuaderno o mentalmente)…
- Explica el caso mejor, promedio y peor de un algoritmo. Da un ejemplo.→ Escribe tu respuesta aquí (en tu cuaderno o mentalmente)…
- ¿Por qué Big-O no te dice el tiempo exacto de un algoritmo? ¿Qué información adicional necesitas?→ Escribe tu respuesta aquí (en tu cuaderno o mentalmente)…
🟢 Cuando termines, revisa las Respuestas modelo y compáralas con las tuyas. La mejor forma de aprender es discutir cada respuesta contigo mismo o con un compañero.